- zip包存储着四种数据:概述、unicode到拼音索引的数组、拼音索引、wav数据。
- 宏MAX_PINYIN_BYTES指示一个拼音最大字节数,值是7,像chuang2。
- 汉字存在多音字。宏RSP_PINYINS_PER_WORD指示一个汉字可拥有的最多拼音数,值是4。一个汉字最多支持4个拼音。
- 结构trsp_pinyinindex表示一个拼音索引,每个索引字节数是sizeof(trsp_pinyinindex)。在概述区,pinyins字段指示了rsp文件中有效的拼音数,的确,拼音索引区的一个索引表示一个拼音,但索引区的拼音数可能超过pingyins。所以不能由pingyins*sizeof(trsp_pinyinindex)得到wav数据的起始偏移,而是应该由概述的wav_start得到这个偏移。
为直观,本文用一个示例来描述拼音rsp。
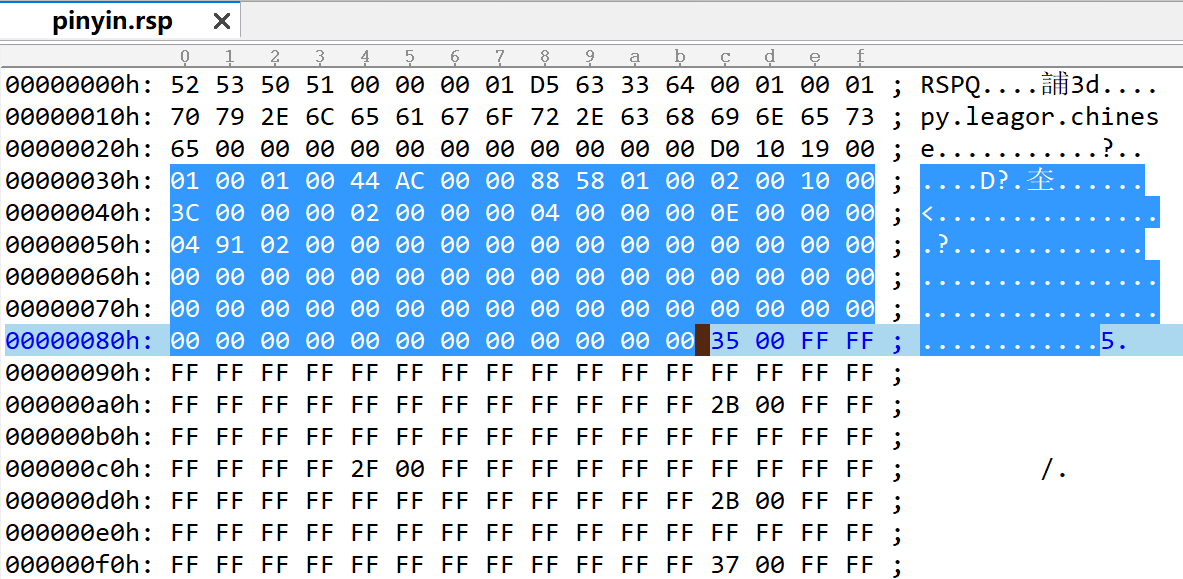
图1中高亮部分是92字节的trsp_pinyin92bytes。
一、第一部分:rsp头(48字节)
Tag3-H4=5(zipt_pinyin)
zip包中数据版本:0.0.1-1681023058(0x64326052)。0.0.1是zip包中版本格式,可认为是拼音的存储格式版本。目前是0.0.1。1681023058是此拼音包的最后修改时间,用C函数time(nullptr)生成。
rose版本:1.0.1。
bundleid:py.leagor.chinese。对拼音,bundleid的第一段建议用“py”。
zip包字节数:0x1910d0 = 1,642,704。可算出该rsp文件字节数:48 + 1,642,704 + 20 = 1642772。而1,642,704由四部分组成。
| 次序 | 内容 | 字节数 | 描述 |
| #1 | 概述 | 92 | 固定字节数。sizeof(trsp_pinyin92bytes) |
| #2 | unicode到拼音索引映射 | 167216 | 固定字节数。get_pinyin_code_bytes() * 2 * RSP_PINYINS_PER_WORD(4) |
| #3 | 拼音索引 | 840 | 可变字节数。wavs.size() * bytes_per_index(14) |
| #4 | wav数据 | 1474556 | 可变字节数。拼音rsp的主要部分 |
二、zip包
2.1 概述
概述存储着拼音描述信息,它是一个trsp_pinyin92bytes结构。
struct twave_format_16bytes {
    uint16_t encoding;        // Actual encoding, possibly from the extensible header.
    uint16_t channels;        // Number of channels.
    uint32_t frequency;       // Sampling rate in Hz.
    uint32_t byterate;        // Average bytes per second.
    uint16_t blockalign;      // Bytes per block.
    uint16_t bitspersample;   // Currently supported are 8, 16, 24, 32, and 4 for ADPCM.
};

#define RSP_MAXDESCBYTES	55
struct trsp_pinyin92bytes {
	twave_format_16bytes format;
	uint32_t pinyins;
	uint32_t bytes_per_index_code;
	uint32_t pinyins_per_word;
	uint32_t bytes_per_index;
	uint32_t wav_start;
	char desc[RSP_MAXDESCBYTES + 1];
};
针对示例,它从0x30开始,占92字节。
- format:描述声音存储格式。一般采用示例中的PCM、单声道、44.1K、S16位。
- pinyins:60(0x3c)。wav数据区存储着60个拼音。
- bytes_per_index_code:2。每个索引编码字节数。2个字节可表示65536个编码,除去0xffff表示无效编码,一个拼音rsp最多存储65535个拼音。
- pinyins_per_word:4(RSP_PINYINS_PER_WORD)。用于多音字,表示每个汉字最多含有的拼音数。一个汉字最多含4个拼音。
- bytes_per_inex:14。sizeof(trsp_pinyinindex)。索引区每个索引的字节数。
- wav_start:168196(0x00029104)。wav数据区开始位置。
- desc:用于描述该拼音使用场景的一个字符串。56字节。
2.2 unicode到拼音索引的数组
数组中每一项是一个trsp_pinyinunicode结构。
#define RSP_PINYIN_NO_INDEX_CODE	0xffff
#define RSP_PINYINS_PER_WORD		4
struct trsp_pinyinunicode {
	uint16_t idxs[RSP_PINYINS_PER_WORD];
};
数组索引表示unicode编码。拼音rsp存储的汉字从unicode编码从0x4E00开始,到0x9FA5结束。索引0对应的是汉字0x4E00,即“一”,索引1对应0x4E01,即“丁”。
数组值是该汉字在拼音索引区的索引编码。每个拼音索引编码2个字节,一个汉字固定4个拼音。当然,汉字很少会有4个拼音,不足4个的,就填0xFFFF,表示无效拼音。
以索引0为例,对应的是汉字0x4E00,即“一”,它有一个拼音,在拼音索引区的53(0x35)。
2.3 拼音索引
一个拼音索引描述一个拼音,除了声音wav数据。
#define MAX_PINYIN_BYTES	7		// chuang2
struct trsp_pinyinindex {
	char pinyin[8]; // chuang2\0, must > MAX_PINYIN_BYTES.
	int offset; // 0 is wav-data
	int16_t size;
};- pyinyin:存储着该拼音内容。像chuang2。汉字拼音最多7个字符,加上一个C语言字符串终止符'\0',用8个字节。
- offset。该拼音在wav数据区的开始偏移。
- size。该拼音在wav数据区的字节数。
读取逻辑定位到offset处,从它开始读size字节,读出的便是该拼音的wav数据。
2.4 wav数据
各个拼音的wav数据。概述区中的format字段指示了当中声音数据格式。所有拼音必须有着一样的格式。
三、压缩pinyin.rsp文件
3.1 背景与目标
当前 pinyin.rsp 文件结构中,自 wave_start 偏移处开始存储的是拼音 WAV 音频数据。为了缩短用户下载耗时,初步设想是将此部分 WAV 音频数据进行压缩存储,并同步将flags字段的bit31置1,以此作为新压缩格式的区分标识。
3.2 方案演进与压缩效果对比
在实际测试中,我们经历了从 Zlib 到 Zstd 的探索,并针对音频特性加入了差分预处理,最终取得了显著效果。各方案具体压缩效果如下:
- 方案一:原始未压缩
数据大小:36.52 MB (38,285,514 字节) - 方案二:Zlib 标准压缩 (Z_BEST_COMPRESSION)
数据大小:33.21 MB
结论:压缩效果极差,仅减少约 3.3 MB,不具备实际优化意义,初始评估中已放弃此方案。 - 方案三:Zstd + 16-bit PCM 差分预处理 (compression_level: 9)
数据大小:26.01 MB
结论:相比原始体积大幅缩减了 10.51 MB,达到约 28.7% 的压缩率。解压速度依然极快(Zstd 的解压性能在音频播放前几乎无感知)。
3.3 最终技术方案确定
经过多轮方案评估与跨平台验证,决定采用 方案三(Zstd + PCM 差分) 作为最终技术方案。
- 压缩端(Studio(Windows)):采用 Zstd 压缩库,压缩级别设定为 9。在压缩前增加 16-bit PCM 差分预处理(Delta Encoding),大幅提高压缩比。
- 解压端(kDesktop Windows / iOS / Android):采用 Zstd 解压库,流式解压后,执行对应反差分(Inverse Delta)还原出原始 PCM 音频流。
3.4 外部工具辅助验证(WinRAR 压缩效果)
为了验证该类型数据在当前技术条件下的最大压缩潜力,我们在打包机环境使用 WinRAR (LZMA2 算法,最高压缩等级) 进行了辅助测试:
- WinRAR 压缩: 36.52 MB -> 23.2 MB。
WinRAR 表现出约 36.5% 的极致压缩率。但需要注意的是,WinRAR 作为闭源的 GUI 商业软件,无法直接集成到kDesktop。该测试结果主要用于证明该音频数据存在约 23.2 MB 的理论压缩下限。
3.5 为什么最终没有选用 LZMA / XZ 算法?
既然 LZMA 可以达到 23.2 MB 的极致体积,但在本项目中,我们最终决定弃用 LZMA(即 liblzma / XZ 库),其原因主要集中在 “集成成本” 与 “解压性能” 两个维度:
liblzma 的源码底层依赖于较多跨平台 POSIX 配置宏(如 config.h、sysdefs.h 等),且内部头文件依赖关系极其复杂。在包含数十个开源项目的巨型工程(包含 WebRTC、MediaPipe、TensorFlow、Chromium 等)中,将 liblzma 的源码作为直接子模块编译,极易引发严重的头文件污染和宏冲突。