引言
在《LeaScript:面向端侧/视觉跟练的动作脚本规范》中,描述了 LeaScript 分层架构中的第一层(原子层) 与第二层(序列层)。
- 原子层解决的是“单个动作标不标准”的问题,由算法工程师维护骨骼点、角度阈值与纠错逻辑。动作库的具体内容(已有哪些动作、每个动作的 ID、名称、演示视频、语义标签)请参见:《LeaScript:动作库》。
- 序列层解决的是“一组操编排得好不好”的问题,由教练/UP主从动作库中挑选动作、排列组合,形成一套完整的“操”。
而这一篇要讨论的第三层——课程层,则站在了更高的位置,回答一个完全不同的问题:
如何把多套“操”,按天(Day)组织成一套科学的、可执行、可商业化分发的训练计划?
课程层不再关心单个动作如何做、单套操如何编排。它的处理单位是操,UP主在这里看不到任何姿态阈值,也无需理解状态机与语音播报。他只做一件事:决定哪一天、要出现哪些操、每套操做几轮。
这也是 LeaScript 三层架构的顶层设计目标所在——彻底解耦,逐层降低创作门槛。
【快速通道】 如果你已经熟悉了动作库(第一、二层)的用法,想直接动手制作课程,可以跳至 [2.1 流水线:从“待做清单”到“可跟练的课程”] 下载 csv 模板。
解耦与开源:课程的“规范”与“实现”是两件事
LeaScript 从设计之初就是开源的。它的规范(<workout>、<state2>、<pose> 等语法定义)不绑定任何一家公司的产品,任何人都可以基于这套规范去实现自己的编辑器、播放器或课程平台。
这一点在课程层尤其重要。
因为课程层天然带有商业化属性——它涉及定价、购买、激活、宽限期、到期,甚至后续的订阅、群发、服务。不同的人,对“商业化”的想象力完全不同:
- 有人想做一次性买断,课程就是一次性商品;
- 有人想做订阅制,课程只是长期服务中的一个“内容模块”;
- 有人想做私域运营,课程是引流工具,真正的变现靠社群与直播;
- 有人想做企业团购,课程需要批量授权、批量激活、批量统计。
LeaScript 规范只定义课程的结构(<wkocourse>、<day>、<workout>),不定义课程的商业逻辑。
kDesktop 是课程层的一种实现。 它选择了“小程序 + 内购 + 群发 + 图表评语”这条路径,但它并不是唯一路径。任何开发者都可以基于 LeaScript 规范,设计出完全不同商业模式的课程层实现。
这也是本篇文章写作的前提:讨论的是课程层的规范,而不是某一款产品的功能。
一、规范:<wkocourse> 的语法定义
1.1 文件结构
<wkocourse> 是一个 .cfg 文件的最外层标签,一个文件有且仅有一个 <wkocourse> 块,它对应着一套完整的“课程”(如“15天瘦腰肚子计划”、“30天久坐体态修复计划”)。
课程层在 LeaScript 的分层架构中属于第三层(顶层)。它的内部单位是“操”(<workout>),而不是“动作”。
<wkocourse> 下包含两个层级:
- 课程级字段:直接写在 <wkocourse> 标签下,描述课程的整体属性。
- <day> 子标签:按天(Day)组织课程内容,每一天下面包含若干个 <workout>。
1.2 课程级字段
| 字段名 | 数据类型 | 必需 | 说明 |
| id | 字符串 | 是 | 课程的唯一标识。映射物理文件名,格式为 id.cfg。命名规范与动作脚本 ID 相同(仅允许英文字母、数字、下划线,不超过 24 字节)。 |
| title | 字符串 | 是 | 课程名称。显示在 App 首页的 tab、课程详情页等处。如“15天瘦腰肚子计划”。 |
| description | 字符串 | 是 | 课程简介。用一两句话向用户说明这门课练什么、适合谁、有什么效果。建议不少于 15 个中文字符。 |
| total_days | 整数 | 是 | 课程总天数。取值范围 1 ~ 90,默认 15。超过 60 天建议拆分为多期。 |
| grace_period_days | 整数 | 是 | 激活宽限期(天)。购买后可在该天数内自由选择激活日;逾期未激活则自动开始 Day 1。取值范围 0 ~ 10,默认 7。 |
| price | 整数(分) | 是 | 课程售价。建议以“分”为单位存整数,避免浮点误差。如 price=1990 表示 19.90 元。 |
| currency | 字符串 | 是 | 货币单位。ISO 4217 三字母代码,如 CNY、USD。 |
| reference | 字符串 | 否 | 课程介绍视频的 URL。用于在 App 课程详情页展示“课程介绍”播放按钮。若为空,则 App 不显示该按钮。 |
| author | 字符串 | 否 | 课程作者署名。用于在 App 中展示创作者身份。 |
| prerequisite | 字符串 | 否 | 前置课程的 ID。如果为空,本课程是主课程;如果不为空,本课程是延伸课程。延伸课程只有购买过前置课程的用户才能看到。只允许指向主课程(即那个课程自己的 prerequisite 必须为空),不允许延伸课程再有延伸课程。(用法见:4.2.1 跟练初期的黄金期:用延伸课程给不同粉丝分层) |
关于 id 命名的补充说明:课程层的 ID 规范与动作层一致——id 直接映射为物理文件名,加载时在文件名后附加 .cfg。多小程序生态下,课程的全局唯一标识由 bundleid + id 组合而成(内部称为 id2)。
关于 price 的补充说明:price 是课程在 App 内展示和购买的依据。实际支付金额建议以服务器返回为准,避免脚本被篡改。
关于 prerequisite 的补充说明:prerequisite 用于建立课程之间的“前置 / 延伸”关系。主课程没有 prerequisite,所有用户都能看到(在满足其它可见性条件的前提下)。延伸课程有 prerequisite,只有购买过前置课程的用户才能看到。
延伸课程不允许再有延伸课程。如果 UP 主想为延伸课程再做一层,他应该重新设计主课程,而不是在延伸课程上继续叠加。
延伸课程可以用于多种目的:覆盖不同难度、做专项修复、做加餐 / 挑战。规范不限定延伸课程的目的,也不限定里面操的 ID 怎么配。UP 主可以根据自己的目的,灵活设计。
1.3 <day> 子标签
<day> 用于定义课程中的某一天(或某几天)的内容。
| 字段名 | 数据类型 | 必需 | 说明 |
| days | 字符串 | 是 | 该天数据对应课程中的哪一天。支持两种写法:单天(如 days="1"),多天复用(如 days="1,3,5,7")。多天写法可大幅缩减脚本长度,避免大量重复的 <day> 块。 |
| title | 字符串 | 是 | 当日标题。只写“今天练什么”(如“肩颈唤醒”、“休息日(轻拉伸)”),不写“第几天”,由系统展示时自动拼接“Day X”。 |
| <workout> | 子块 | 否 | 当天要执行的操。一个 <day> 下可包含 0 ~ 9 个 <workout> 块。 |
关于 days 的补充说明:字段名使用复数 days,既能表达“多天复用”的语义,也明确提示解析器这是一个按逗号分隔的数字列表。day 为非法字段,解析器应予以拒绝。
1.4 <workout> 子标签
<workout> 用于定义某一天中要执行的单套“操”。
| 字段名 | 数据类型 | 必需 | 说明 |
| id | 字符串 | 是 | 引用序列层的“操”ID。如 lea_plank、xiyuan_shoulderneck。课程层不直接引用动作(原子层),只引用操(序列层)。 |
| rounds | 整数 | 否 | 该操在当天执行的轮数。取值范围 1 ~ 8,默认 1。超过 8 轮应拆分或减少轮数。 |
| note | 字符串 | 否 | 健身操备注。用一两句话说明该操在当天训练中的角色,如“基础热身”、“核心强化”、“可选替代”。 |
关于 rounds 的补充说明:一轮 = 该套操完整执行一遍。如“平板支撑60秒 + 眼镜蛇拉伸”这套操,做 1 轮就是完整做完“平板支撑60秒 + 眼镜蛇拉伸”;做 2 轮就是再做一遍。“100% 完成”是针对单轮而言的——完成 1 轮计数 +1,逐轮累加。
1.5 一天的校验规则
- 每一天都必须有 <day> 标签,即使这天什么操都不做(休息日),也必须写一个 <day>,在 title 里注明“休息日”。
- 每一天的 title 都不能为空。如果这天没有安排任何操,title 也必须写清“休息日”之类的说明。
- 一天内的 <workout> 数量建议在 1 ~ 9 之间。其中第 9 个可作为“可选替代”操(二选一),用于给不同水平用户提供退阶/进阶选择。
1.6 一个课程脚本示例
[wkocourse]
    id="posture_fix_30days"
    title="30天久坐体态修复计划"
    description="30天久坐体态修复。拉伸肩颈、强化腰背、矫正圆肩驼背。"
    total_days=30
    grace_period_days=7
    price=0
    currency="CNY"
    reference="https://www.bilibili.com/video/BV1m2bh6VEv8"
    author="阿见见Zz"
    [day]
        days="1"
        title="肩颈唤醒"
        [workout]
            id="xiyuan_shoulderneck"
            note="肩颈+体态"
        [/workout]
    [/day]
    [day]
        days="2"
        title="肩颈放松"
        [workout]
            id="lea_shoulderneck_10s"
            note="肩颈操,拉伸颈侧"
        [/workout]
        [workout]
            id="lea_plank_cobraflow"
        [/workout]
    [/day]
    [day]
        days="3,5,7"    # 第3、5、7天复用同一套安排
        title="核心唤醒"
        [workout]
            id="lea_pelvictilt"
            note="矫正骨盆前倾"
        [/workout]
        [workout]
            id="xiyuan_shoulderneck"
        [/workout]
    [/day]
    # ... 其余天数
[/wkocourse]
二、工业化生产:课程是如何被“制造”出来的
LeaScript 三层架构的终极目标,不是发明一套新的脚本语言,而是把原本感性的“内容创作”过程,拆解为理性的“工业化生产”流水线。
在传统模式下,一个健身 UP 主想出一套 30 天课程,他需要构思动作、演示、录制、剪辑、配音。整个过程高度依赖个人能力,较难复制、较难规模化。
而 LeaScript 的三层架构,把这件事拆成了三段:
- 原子层:算法工程师负责定义“动作标不标准”。
- 序列层:教练/UP主负责决定“一组操怎么编排”。
- 课程层:课程策划负责规划“哪一天练哪些操”。
这三段之间,通过 .cfg 文件完全解耦。每段的生产者只需要专注自己的环节,做出来的东西可以被下一环节直接复用。这就是工业化生产的基本形态:分工明确、标准统一、接口清晰。
2.1 流水线:从“待做清单”到“可跟练的课程”
工业化生产的核心特征,是输入和输出标准化。
在 LeaScript 体系里,一个 UP 主要制作一套课程,他只需要给出最上层的 “课程待做清单”(CSV 文件)。(如图1 所示):
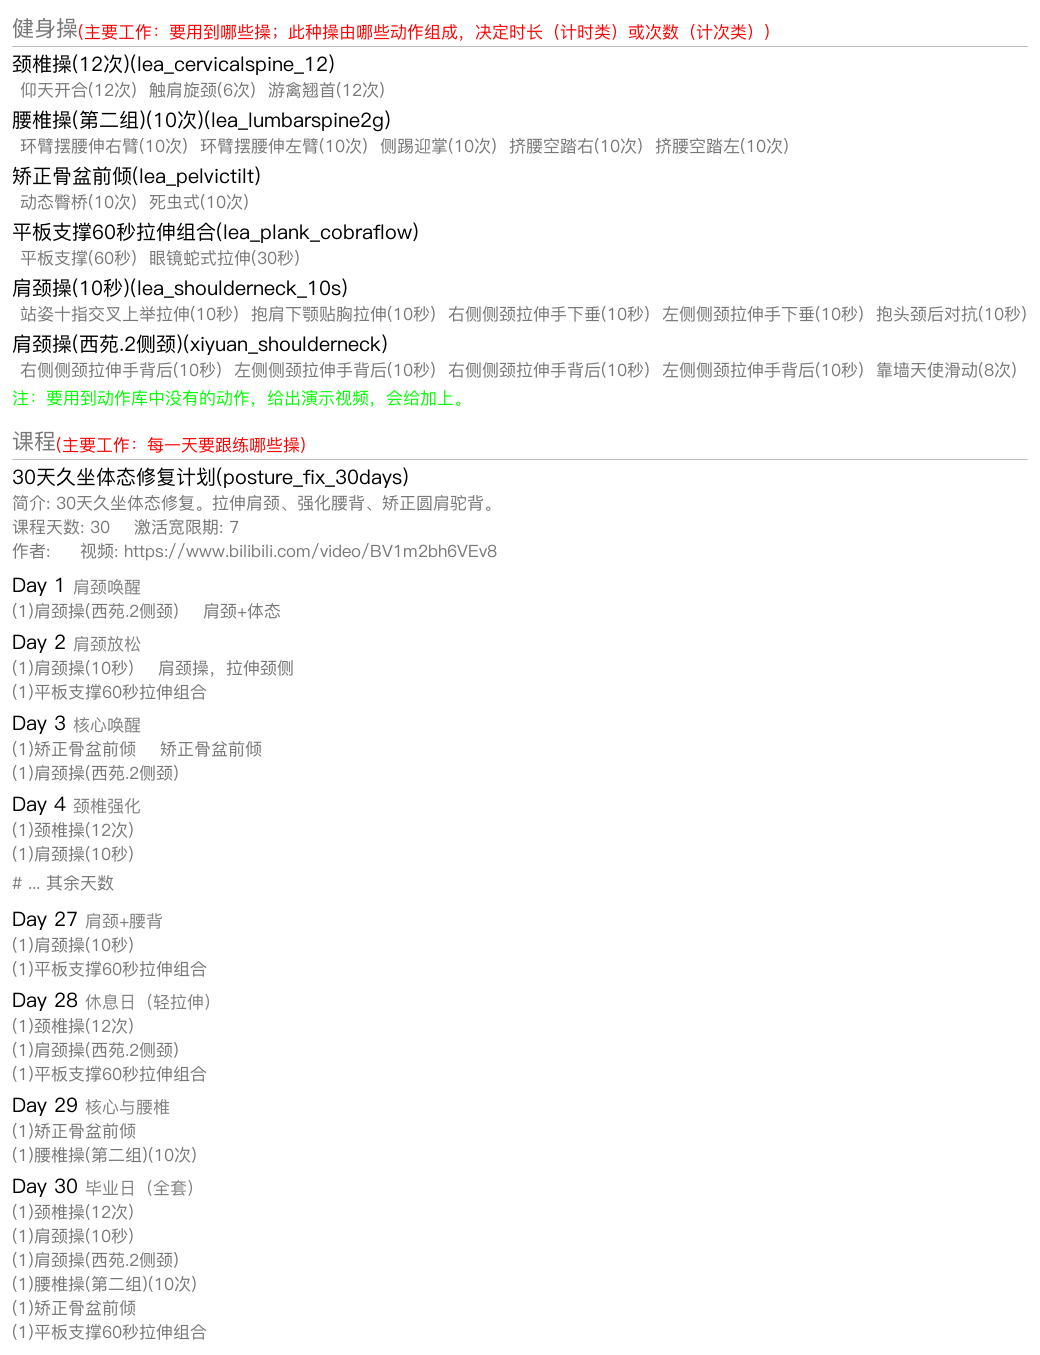
这份清单,就是课程层的全部输入。
- 课程脚本生成:根据待做清单,自动生成 <wkocourse> 脚本,确定每一天要做哪些操、做几轮。
- 操脚本生成:根据每个操的动作和次数/时长,自动生成 <workout> 脚本,把原子层的动作排列组合成一套完整的操。
- 原子层复用:动作直接从 action_tpl2s.cfg 动作库中引用,无需重复定义姿态阈值和纠错逻辑。
提示:这份清单不仅可以生成完整课程,您也可以只保留 Workout 区域,删掉 Meta 和 Day 区域,实现一键批量生产单操脚本。
下载标准模板:[posture_fix_30days_demo.csv 模板下载](提示:动作的 Name/ID 可在《LeaScript:动作库》中查询并复制)
剩下的工作,由 Launcher 流水线自动完成:
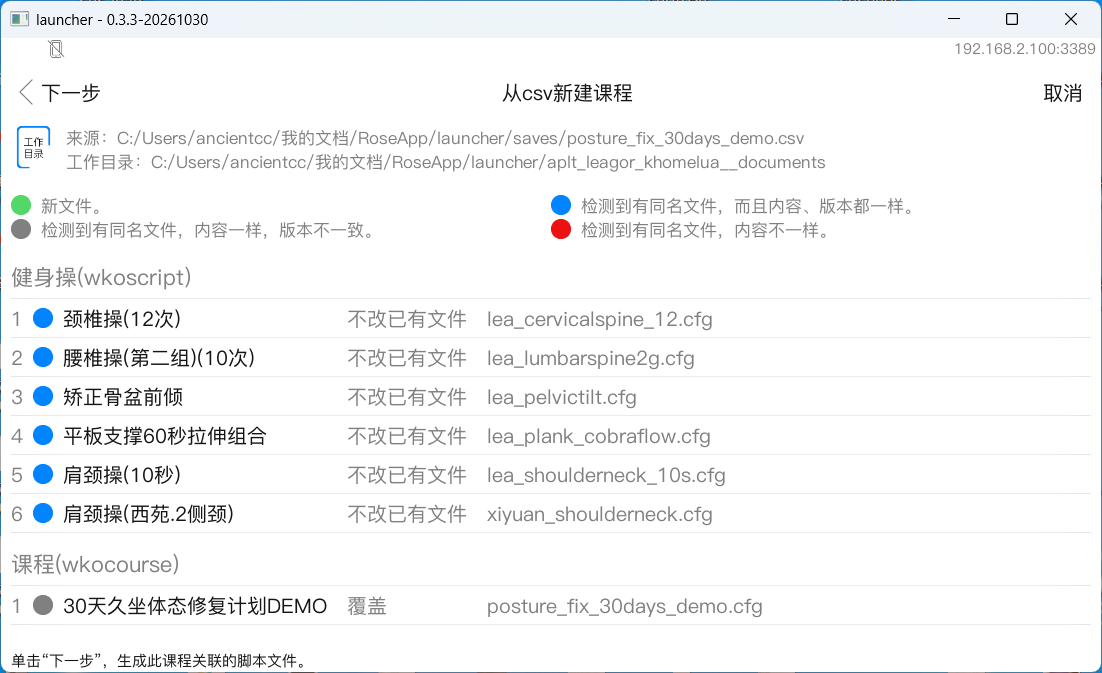
如图2 所示,Launcher 会自动检测同名文件、比对内容与版本,并列出即将生成的 .cfg 脚本文件。点击“下一步”即可生成全部关联脚本,人力、时间成本几乎为零。
这就是工业化生产的意义:把“创作”变成“组装”。
2.2 质量如何不降?
工业化生产有一个担忧:量上来了,质量会不会下来?
LeaScript 的答案是:质量由规范保证,不由人保证。
- 动作质量:由原子层决定。每个动作的姿态阈值、计次逻辑、纠错语音,都由算法工程师或高级教练一次性定义好,全平台复用。动作的标准是统一的,不会因为 UP 主不同而不同。
- 操的质量:由序列层的校验规则决定。比如,每个操的时长必须 ≥ 30 秒;每个动作的阈值可以覆盖,但不能改变 diff_id 结构。这些硬性约束,保证了操的“基本质量”。
- 课程的质量:由课程层的校验规则决定。比如,每一天都必须有内容(休息日也要写清楚);每一天的操数必须在 1 ~ 9 之间;每一天的 title 不能为空。这些规则,保证了课程的“完整性”。
这里有一个关键点:UP 主的“待做清单”一旦确定,后续的脚本生成、校验、导出,都是由程序自动完成的。程序不看“量大量小”——它只认规范。 待做清单是 10 天的课还是 90 天的课,动作层、操层、课程层的校验规则完全一致,不会因为课程长了就“松一点”,也不会因为课程短了就“紧一点”。
这就是工业化生产的意义:把“质量把关”从“人盯人”变成“程序执行”。 只要规范是程序,量大量少,质量的下限就一样稳。
换句话说,工业化把质量下限从人转移到规则,把质量上限仍然留给专业审核与数据反馈。
2.3 AI:流水线的柔性引擎
工业化生产还有一个目标:让生产更灵活、更智能。 这是 AI 要解决的问题。
LeaScript 体系对 AI 的态度是:AI 是流水线的柔性引擎,不是黑盒替代品。 它的落地需要分层推进:课程层最容易,操层次之,动作层最难(但必须靠语义元数据支撑)。
在动作层:动作层是质量与安全的底线,因此最终判定不能交给黑盒。
端侧 AI 在过去几年里进步极快。随着模型小型化、手机算力提升,完全本地运行、不联网、不涉及隐私的端侧 AI,正在越来越逼近实用。未来一两年内,它很可能在动作识别中扮演重要角色。
但即便端侧 AI 再强,我们也不建议让它“一句话判定深蹲做得对不对”。原因有三:
- 可解释性:健身安全要求每一次“不标准”都能回溯到明确的骨骼点、角度/差值、阈值区间与触发原因。黑盒模型给出的“不达标”三个字,对用户和教练来说,既没有指导价值,也难以申诉。
- 可验证性:一个动作的判定规则,必须能接受回放样本、离线评测、安全边界和人工评审。黑盒模型的行为,很难做系统性的回归测试。
- 可控性:AI 可以提出新的候选规则、候选阈值,但最终是否进入 action_tpl2s.cfg,必须经过显式审核。否则,一次模型更新就可能让全平台的动作判定标准悄悄漂移。
因此,动作层对端侧 AI 的定位是:能进原子层,但不能拿黑盒当终审。
AI 适合做“增强规则”的事:
- 关键点稳定、遮挡/抖动/缺失修复;
- 两阶段切换的概率平滑;
- 个性化阈值校准(比如根据用户的身高、柔韧性做微调);
- 危险模式识别(比如发现用户明显偏离安全姿态);
- 提示语改写(把纠错语音说得更自然)。
而这些增强,最终都要回到一个可解释的 <pose> 规则上。AI 的输出,是让规则更稳、更准、更个性化,而不是替代规则。
为此,动作层不只要存阈值,还要存语义。这就是我们建议增加的“语义元数据”字段:
- body_part:部位标签,如 core、shoulder、neck、back、hip、knee、ankle。
- level:难度等级,如 beginner、intermediate、advanced。
- movement_type:动作类型,如 strength、stretch、cardio、balance、mobility、rehab。
- training_role:训练角色,如 warmup、main、cooldown、activation。
- risk_flag:风险提示,如 lumbar_knee_shoulder_caution、pregnancy_caution。
- contraindication_hint:禁忌/退阶提示,供 AI 在生成课程或操时规避。
这些字段不改变现有的物理执行层(<track_pose>、<task>、<pose>),只是在 <action_tpl2> 上增加一组可选的语义标签。人类看 name 和 msg,AI 与校验器看语义字段。 语义标签应使用受控词表 + 版本号,避免 AI 生成无法归并的自由文本。
在操层:给 AI 一份“动作 + 次数/时长”的清单,它已经能生成基础的 <workout> 脚本。但“准确”这件事要分两层看:语法正确(AI 完全能做到,因为标签结构是固定的)、内容合理(AI 不一定能做到,比如把拉伸排到热身前面,或把两个高强度动作连续排在一起)。所以,操层的原则是 “AI 负责生成,规则负责校验”。
在课程层:语法比操层更简单——它只有 <day> 和 <workout> 两层结构,不涉及姿态、阈值、状态机。所以,一旦给 AI 一份待做清单(图1 中的课程部分),AI 生成 <wkocourse> 脚本的准确率会非常高。课程层是 AI 落地最快的场景。
2.4 为什么 AI 是必须的?
因为跟练 App(像 kDesktop)不可能内置一整个编辑器模块。
编辑器(Launcher)是一个复杂的状态机可视化工具,它需要渲染 <state2> 流程图、渲染 <pose> 参数面板、处理 diff_id 覆盖逻辑。它的体积和复杂度,不适合放在一个“跟练”为主的 App 里。
但用户在使用 kDesktop 时,可能会临时产生需求:
- “我今天不想做课程里的操,想换成另一种”;
- “我腰不舒服,能不能给我生成一套舒缓的拉伸操”;
- “我想给这个课程加一天休息日”。
如果这些需求都要求用户打开 Launcher,体验就断了。所以,kDesktop 需要一个轻量级的、能理解 LeaScript 的 AI 引擎,在用户说几句话的时候,就能生成或修改 <workout> 或 <wkocourse> 脚本,然后直接开始跟练。
这就是 AI 在 LeaScript 体系里的定位:它不是替代编辑器,而是作为“轻量级生成器”嵌入到跟练 App 里,让脚本生成从“编辑器里点选”变成“对话里生成”。
而这套机制的底层支撑,依然是三层架构的彻底解耦——AI 不需要理解骨骼点,它只需要理解“操”和“课程”的语义,就能生成可执行的脚本。AI 是流水线的柔性引擎,不是流水线的替代品。
三、报表与商业化:从“卖脚本”到“卖服务”
3.1 在 LeaScript 体系下,为什么“卖脚本”很难赚钱?
LeaScript 从设计之初就是开源规范,三层架构(原子层、序列层、课程层)全部解耦,脚本本身是纯文本的 .cfg 文件。
这意味着:
- 操脚本:一旦被复制到本地,就是一份可读、可编辑的文本。外人拿到一个 <workout> 脚本,跟练几次,就能大致猜出它的动作顺序、次数、时长。
- 课程脚本:更简单。<wkocourse> 只包含“哪天做哪些操、几轮”,本质上是一份时间计划表。外人拿到一次课程进度图,甚至只要跟练一遍,就能把课表倒推出来。
换句话说,脚本是“配方”,不是“产品”。 配方可以被抄走,但产品背后还有体验、服务、社群和信任。靠卖脚本赚钱,等于把配方当产品卖,很难成立。
真正的商业机会,在于 LeaScript 提供的“详细做操数据”。 它让 UP 主可以为粉丝提供传统视频跟练 App 无法提供的精准服务。
3.2 LeaScript 在数据层提供了什么?
LeaScript 在原子层和序列层的设计,使得 kDesktop 能精确记录用户做操过程中的每一个姿态。这是所有服务的基础。
数据文件的结构
每一天的做操数据,存放在一个独立的 health2026xxxx.dat 文件中(如 health20260927.dat)。各文件相互独立,互不干扰。
health2026xxxx.dat 内部包含 5 个部分:
| 成员变量 | 核心语义 | 存放数据 | 数据形式 | 生命周期 |
| event_items | 事件流水账 | 做操+坐姿的混合事件 | 结构体数组 | 全天持续写入 |
| workout_cfg_strs | 做操脚本配置 | 做操脚本文件 | 字节流(长度+内容) | 每次开始新操时写入 |
| zip_workouts | 已完成操的录像 | 压缩后的姿态点 | 压缩字节流 | 做操完成后追加 |
| unzip_workout | 进行中操的缓冲区 | 未压缩实时姿态点 | 未压缩字节流 | 仅当前做操期间存在,完成后清空 |
| workout_tlvs | 做操扩展统计 | TLV 字节流 | TLV 字节流 | 每次开始新操时写入 |
关于数据大小的说明
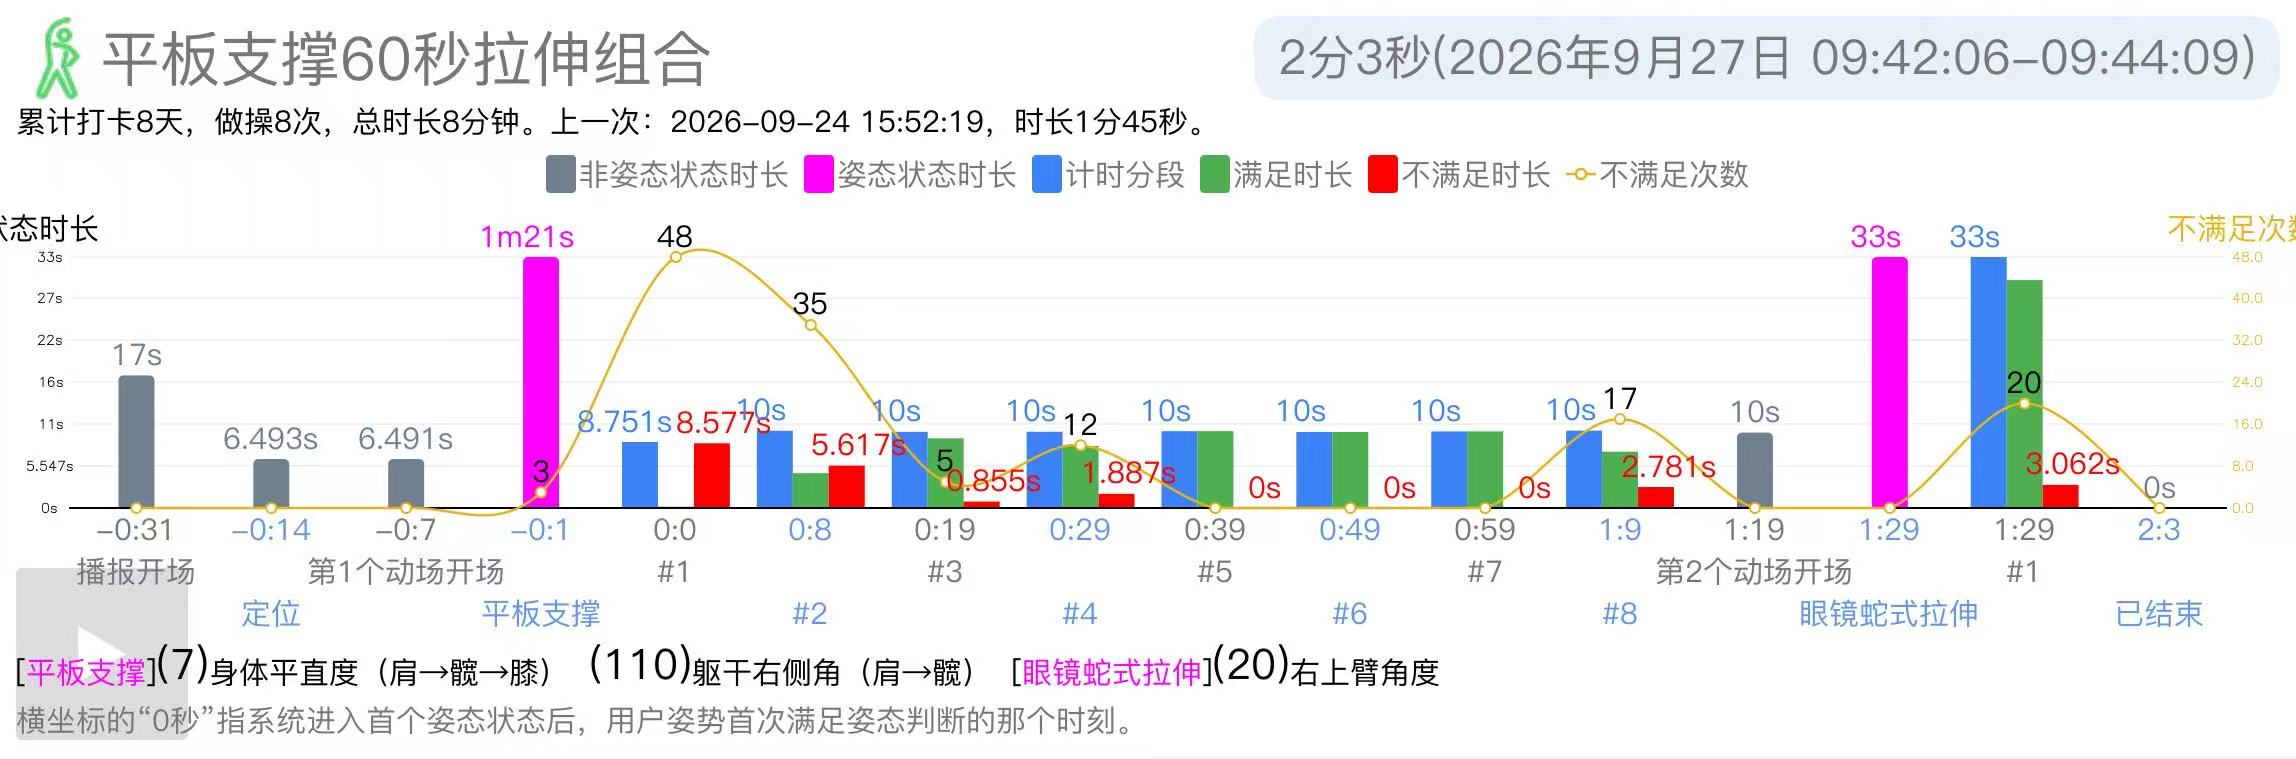
zip_workouts 存储做操过程中所有姿态点数据,即使经过 zip 压缩,体积仍然不小。以图3 那次“平板支撑60秒 + 眼镜蛇拉伸”(约 2 分钟)为例,zip_workouts 大约有 45KB;其它三个字段(event_items、workout_cfg_strs、workout_tlvs,此时 unzip_workout 已清空)合起来大约 10KB。
如果只是展示静态数据、不需要火柴人回放,可以去掉 zip_workouts,生成一个“精简版”文件,用于节省流量。后续做云端服务时,可以按需选择是否携带 zip_workouts。
基于数据可以生成的报表
基于 health2026xxxx.dat 数据,可以生成两类报表。
第一类:单操图表
对某一次具体的做操,可以生成一张完整的做操图(见图3)。这张图不依赖 zip_workouts 和 unzip_workout,只使用统计数据。
图中会展示:动作分段、满足时长、不满足时长、单次耗时、不满足次数等。顶部还会显示打卡摘要:“累计打卡8天,做操8次,总时长8分钟。上一次:2026-09-24 15:52:19。”
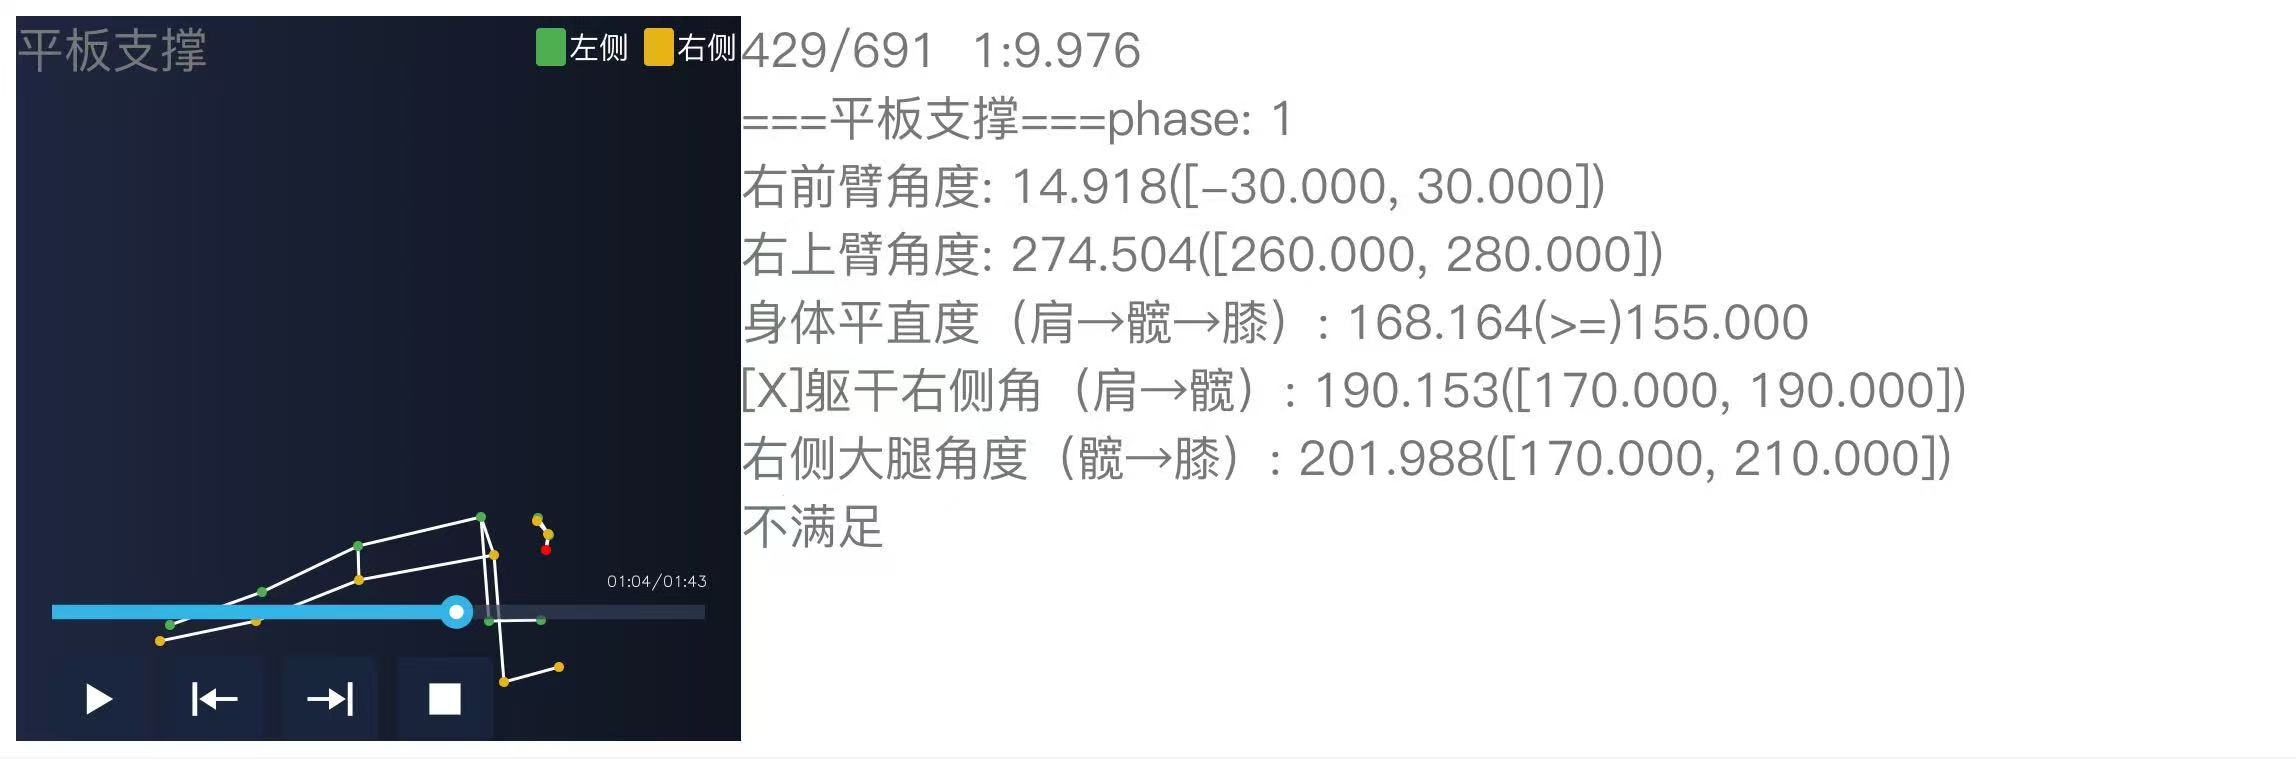
点击左下角的播放按钮,可以进入火柴人回放(见图4)。这时就需要用到 zip_workouts 中存储的姿态点数据。
要发现问题,最关键的是不满足原因。在做操图中点击某个分段,会显示不满足原因的发生时刻(见图5)。
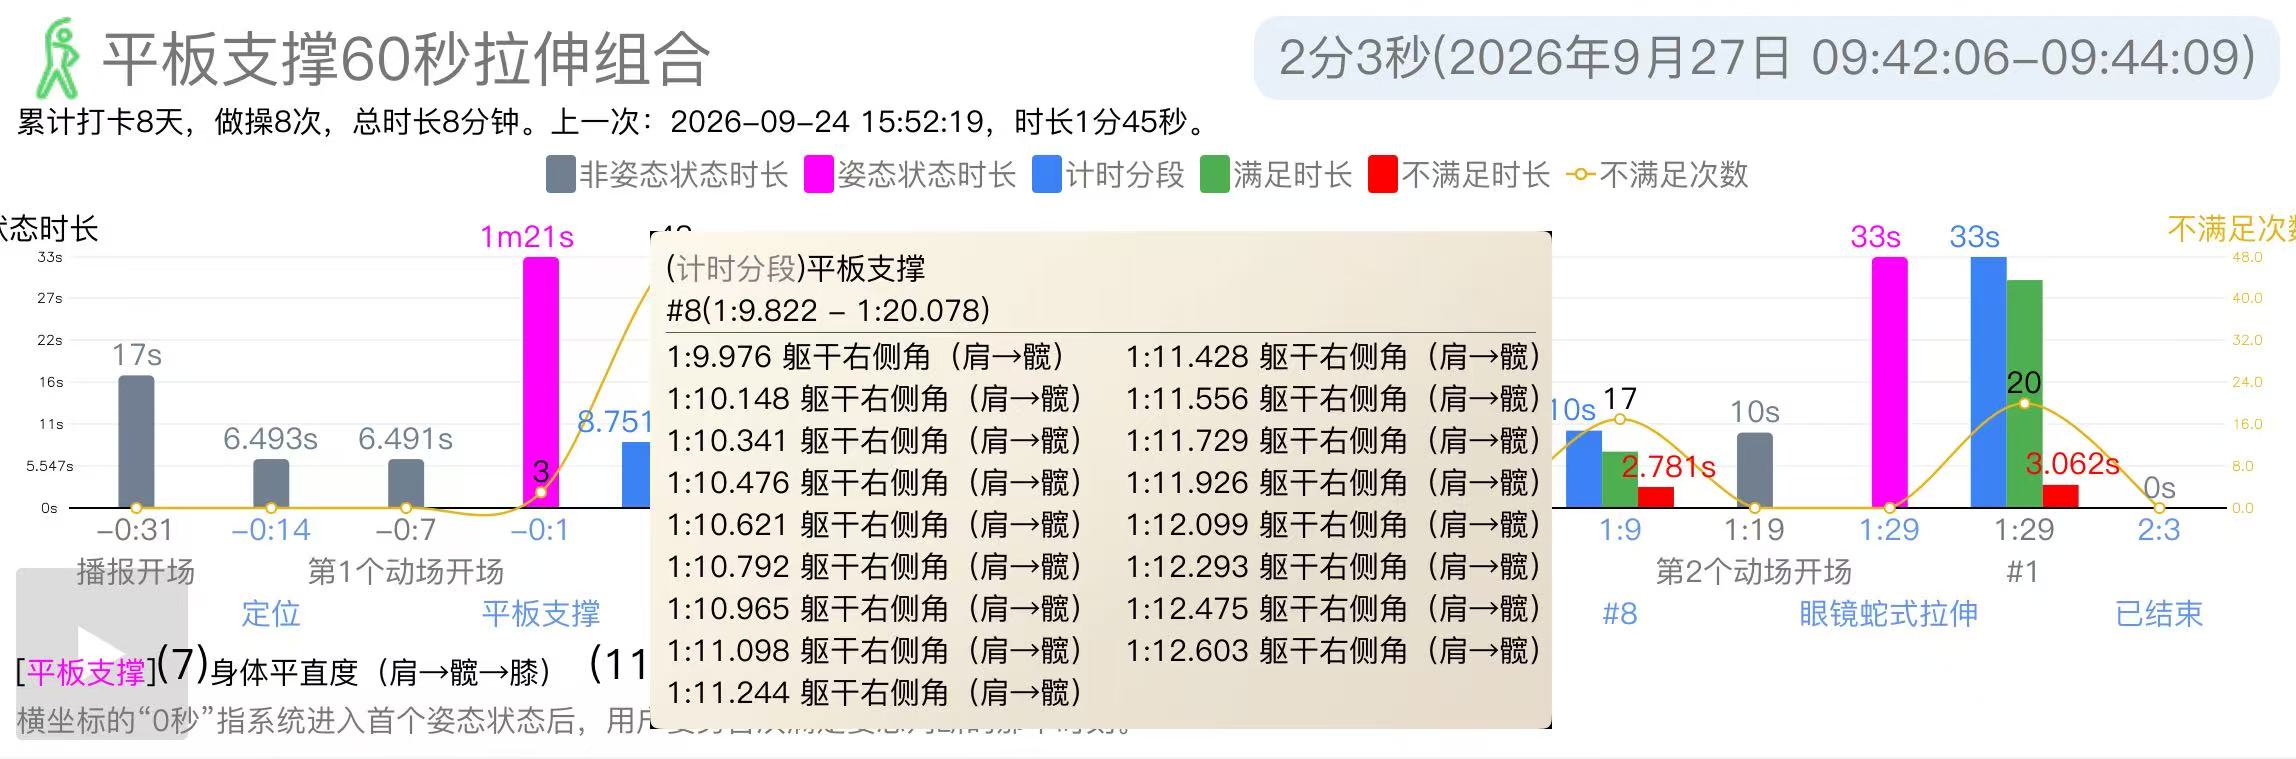
比如:做操到 1 分 9.76 秒时,系统报出“肩→髋角度不满足”。这代表出现了塌腰或撅臀,具体是哪种,可以结合火柴人动画回看。查看图4 的数据,肩到髋角度是 190.153,超过了最大值 190,意味着腰比肩低,原因是塌腰。
第二类:复合报表
复合报表把多次做操的数据聚合在一起,用于观察趋势和整体进度。
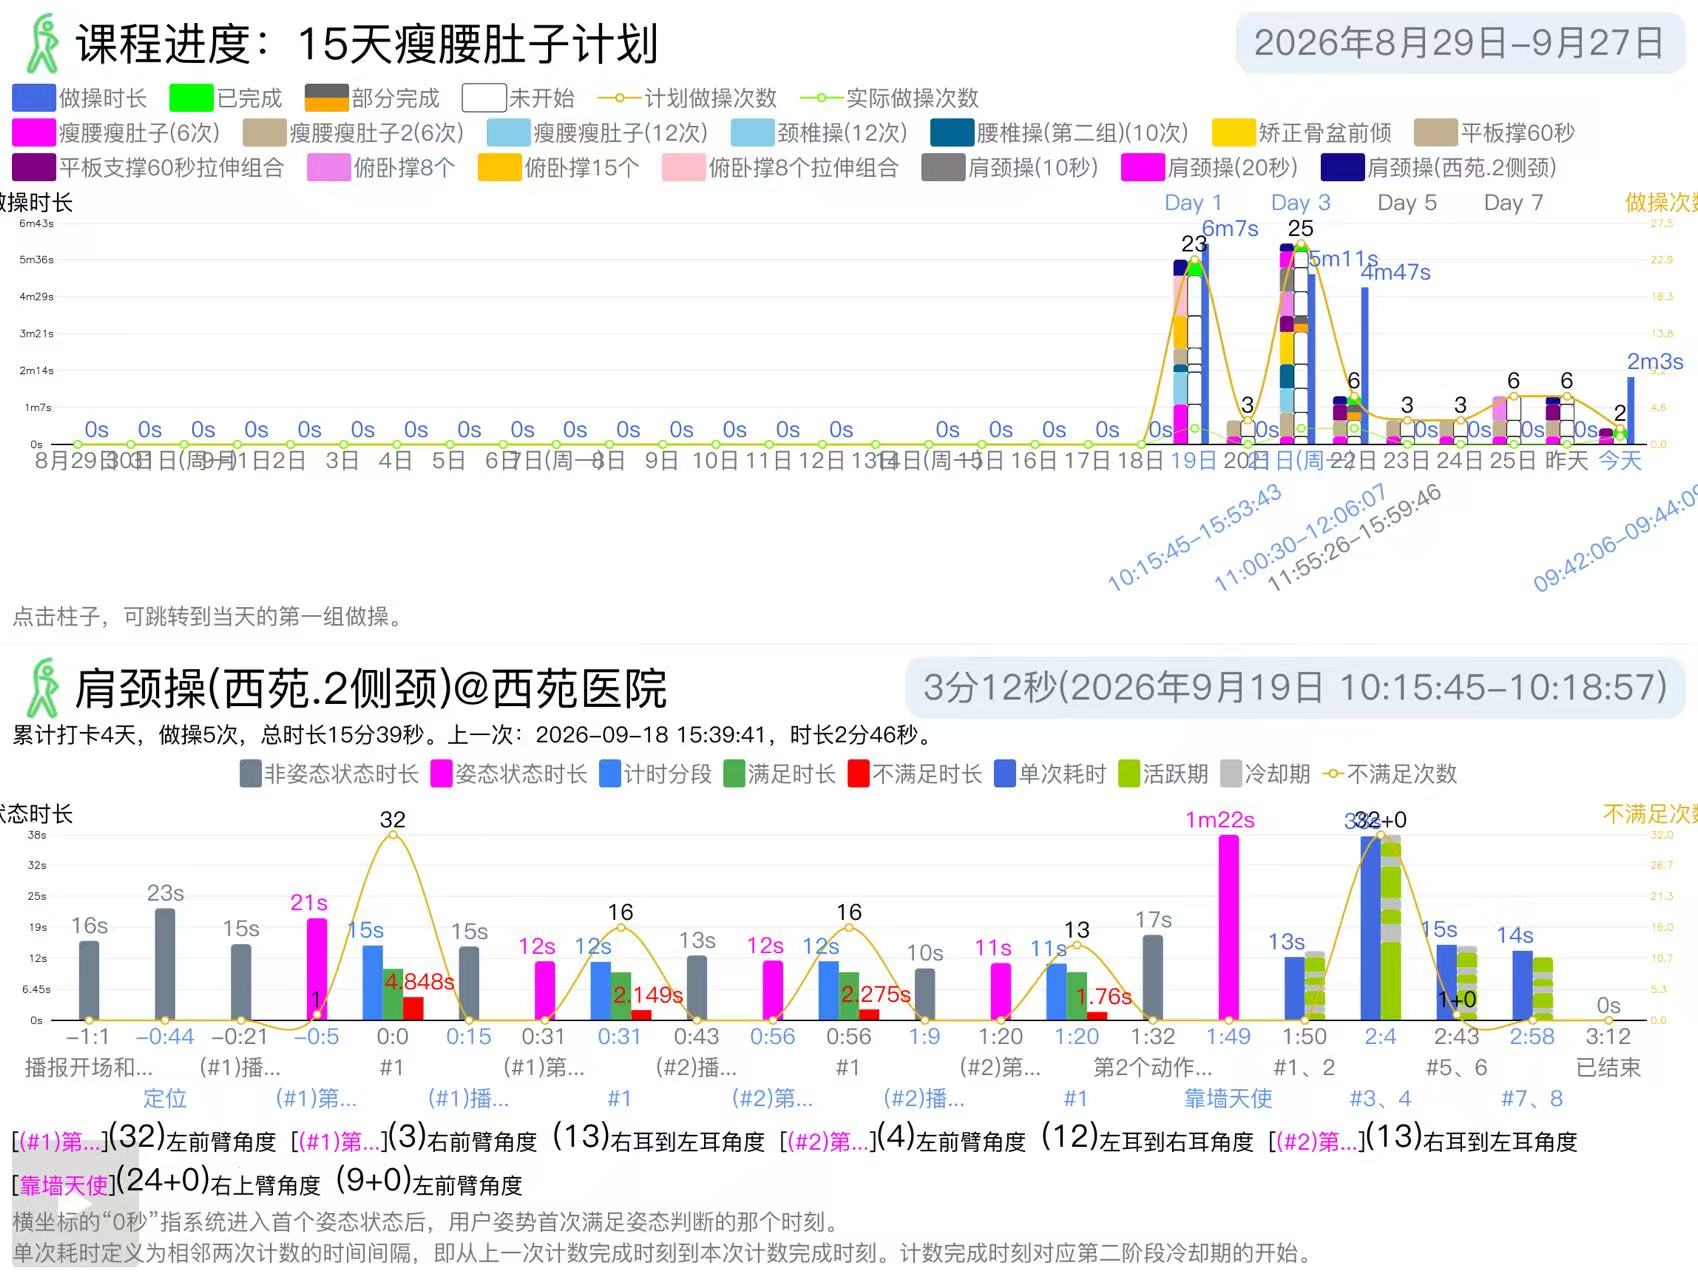
课程进度(见图6):第一张图是课程概览(按天展示计划 vs 实际),接下来是该课程内每一次做操的图表。
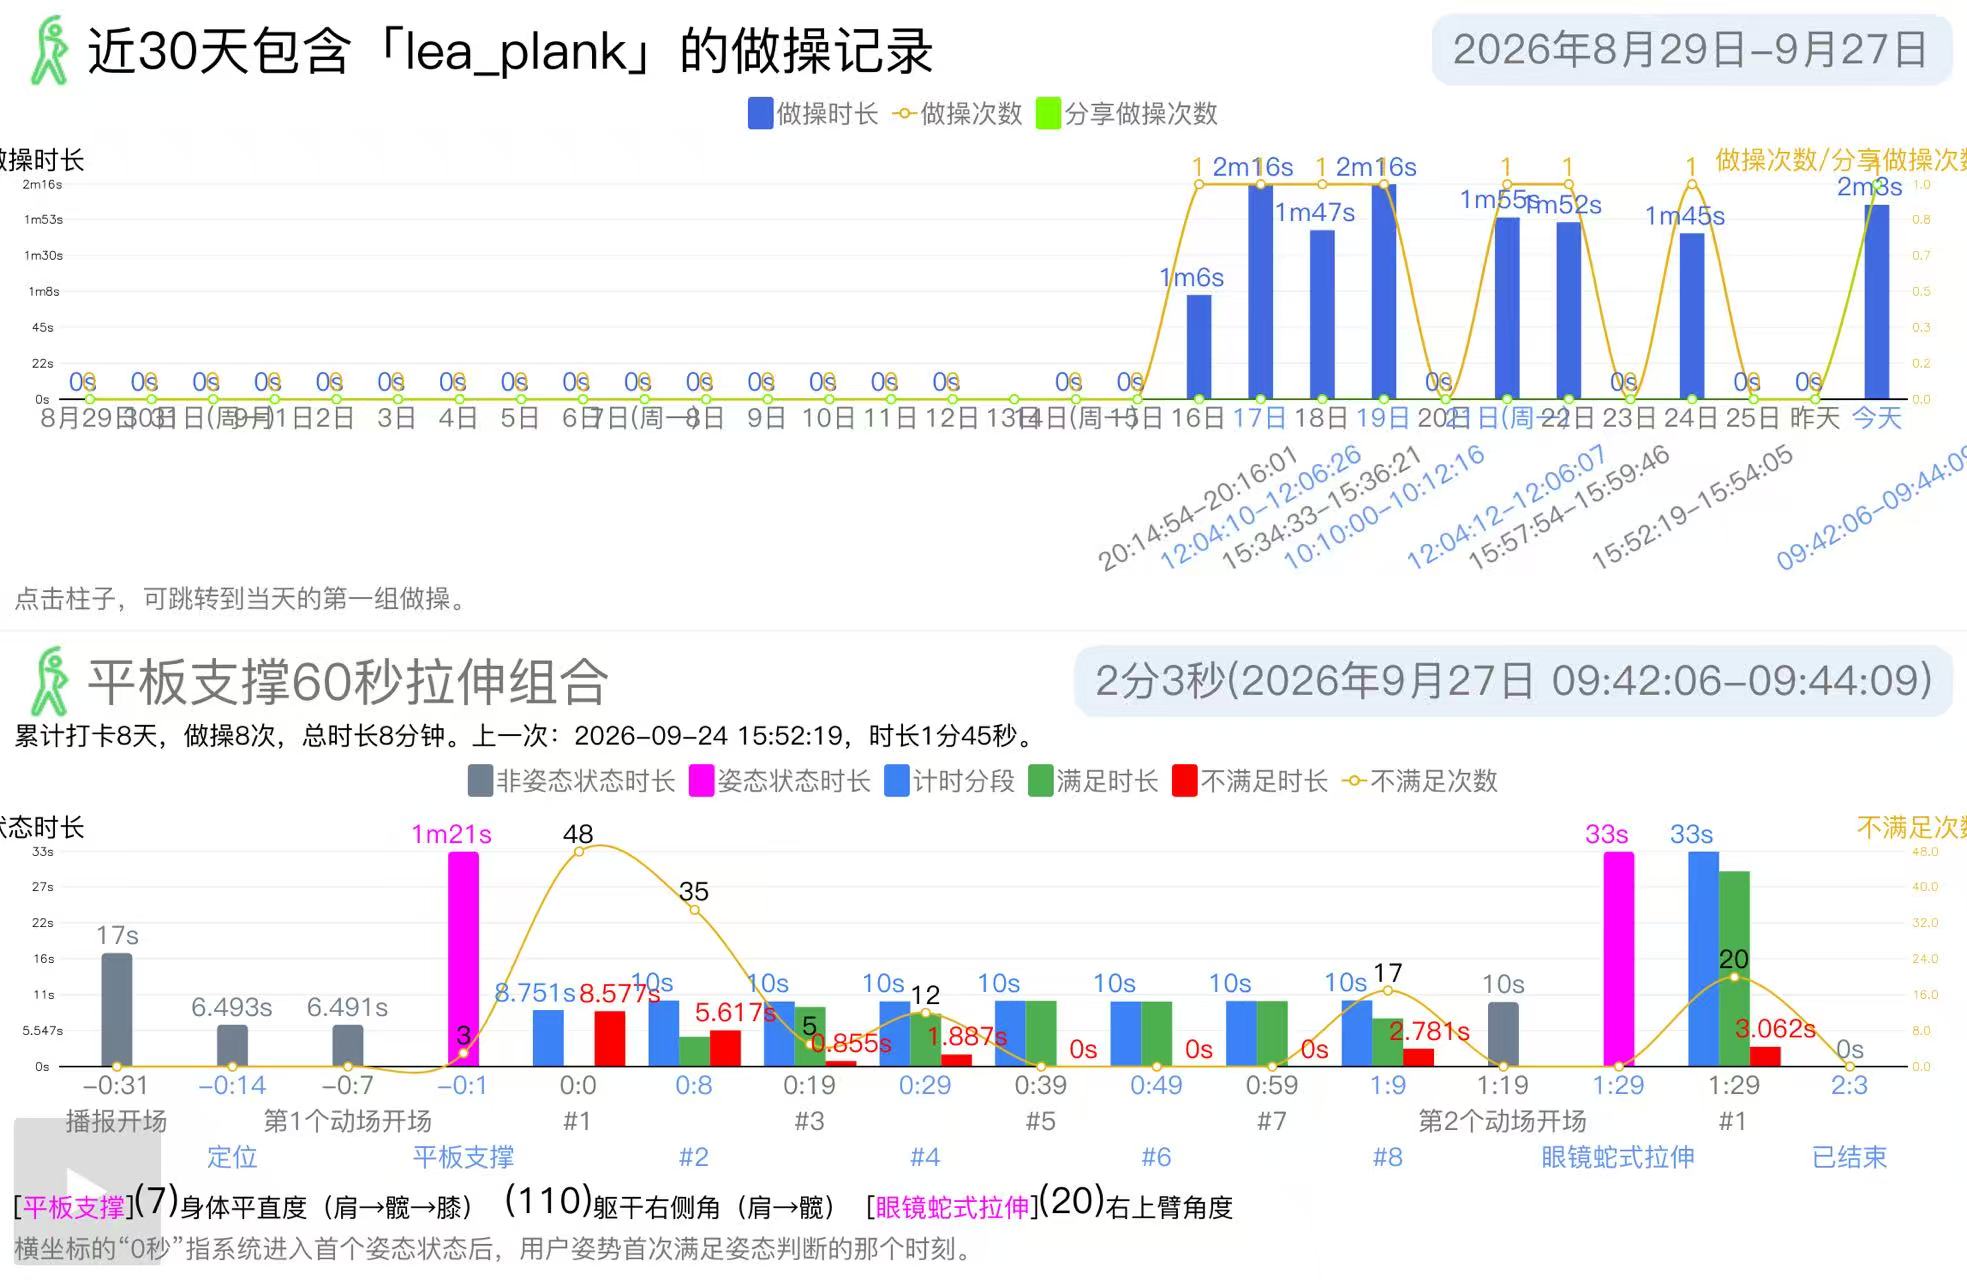
近 30 天含某 ID 的做操记录(见图7):第一张图是概览(每一根柱子代表一天),接下来是每一次做操的图表。这让 UP 主一眼就能看出所有平板撑记录。
动态数据:一键生成 vlog
除了静态报表,LeaScript 的数据层还有一个动态能力:跟练过程中,实时数据(姿态点、计时、累计打卡)可以叠加在视频画面上,配合录屏,即可生成一段完整的跟练 vlog。
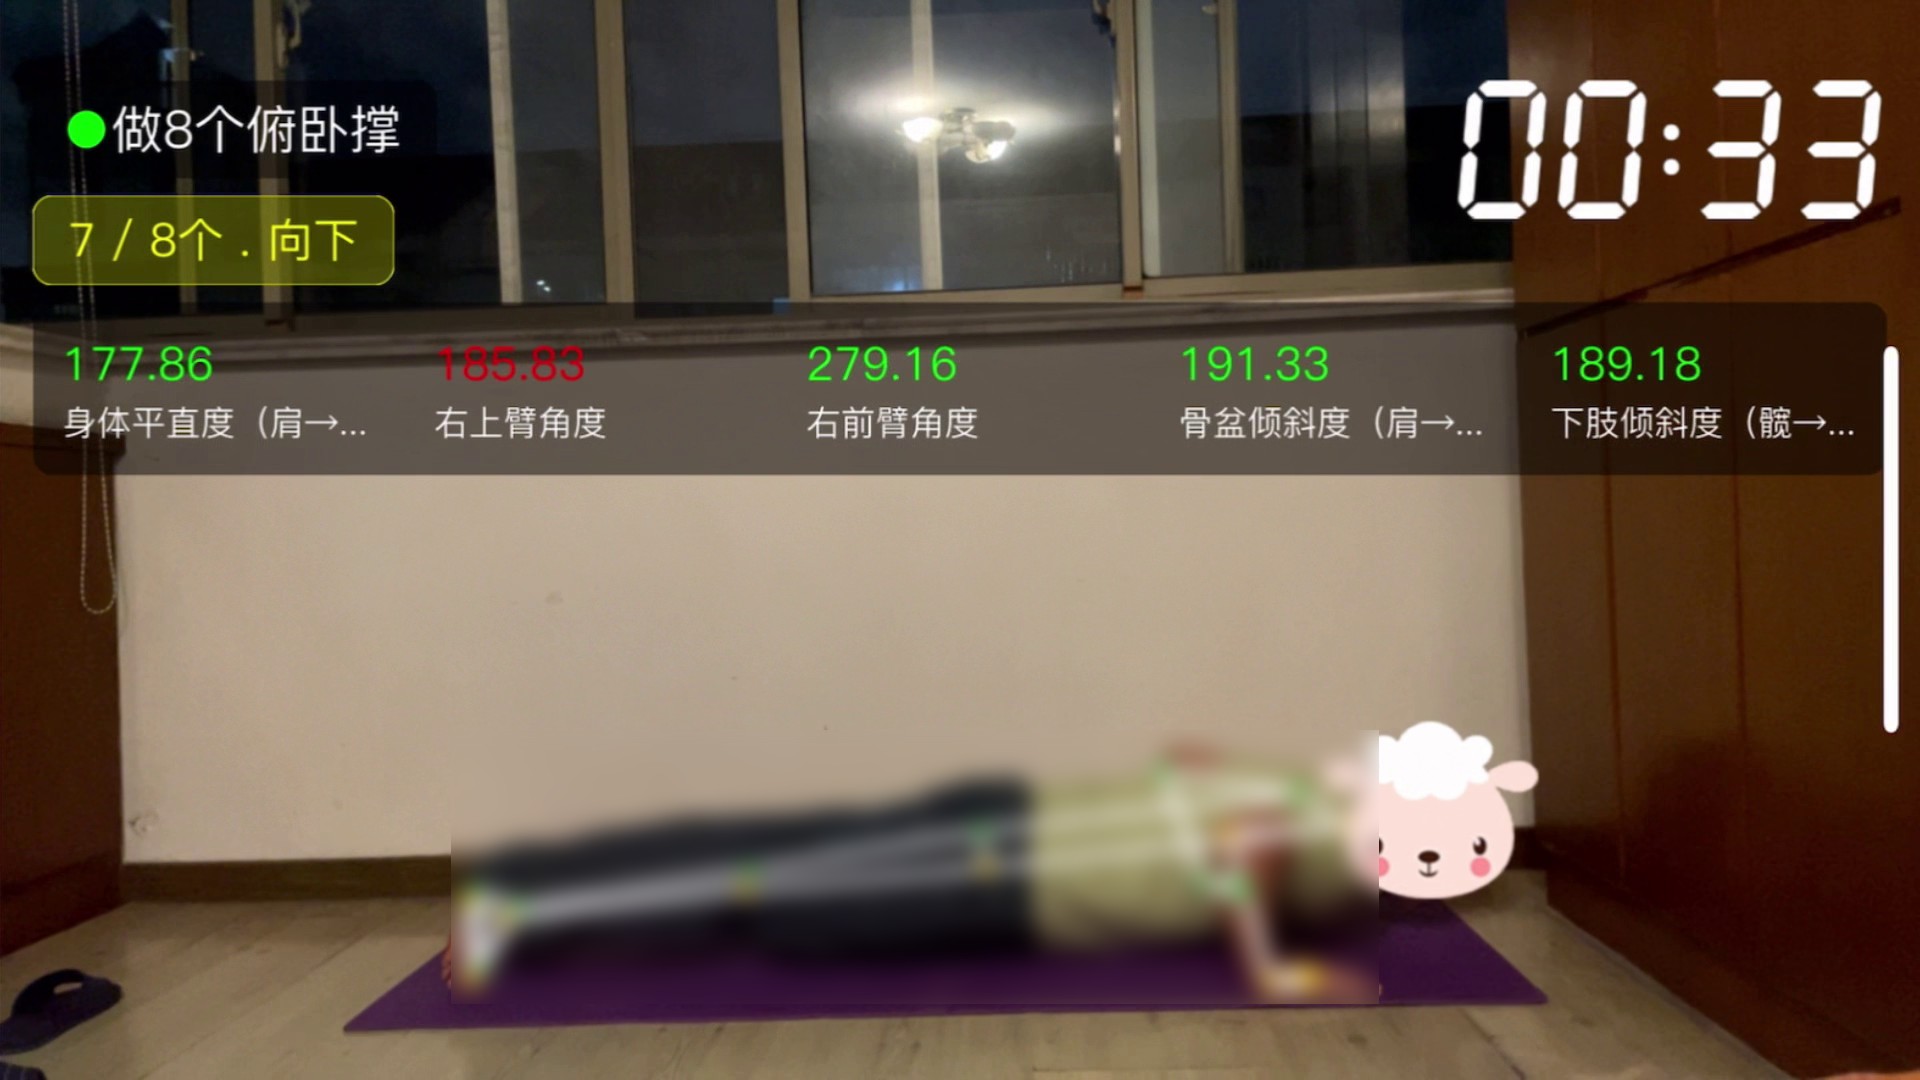
这和报表的区别在于:报表是“事后复盘”,vlog 是“过程记录”。报表侧重分析,vlog 侧重分享。
对 UP 主来说,vlog 的意义不只是“让粉丝发个朋友圈”。它让“社群挑战赛”这类活动有了落地的基础。粉丝的 vlog 格式统一、数据真实、可直接聚合。UP 主可以把它们剪成合集,发到 B站、抖音,形成二次传播。
报表是把“个体”的数据提炼给 UP 主看;vlog 是把“个体”的体验分享给更多人看。
3.3 基于数据,课程可以有哪些服务?
有了上述详细数据,UP 主可以为粉丝提供传统视频跟练 App 根本无法提供的服务。
1. 群发消息(UP主 → 粉丝群)
因为 LeaScript 能保证 UP 主看到的数据是真实的,UP 主可以确信粉丝做操时“主要姿态是满足的”,而更需关注的,是强制手机检测不出的部分,比如深呼吸、腰要压平。
UP 主可以按时查看粉丝提供的数据,然后隔几天做一次直播,针对数据中暴露的问题集中答疑。
2. 图表评语(UP主 → 单个粉丝)
粉丝向 UP 主发送某次做操的图表,UP 主对图表做出回复。这条回复会自动、永久地显示在粉丝的该次做操图表中。这相当于“AI 私教 + 真人教练”的双重加持,是 LeaScript 体系独有的一种服务形态。
3. 其他可能的服务
- 个性化课程调整:UP 主根据粉丝的做操数据,发现某个操对该粉丝难度偏高,可以为该粉丝单独调整课程脚本(比如降低轮数或替换成退阶操)。
- 社群挑战赛:基于 health2026xxxx.dat 的统计数据,平台可以组织“连续打卡 7 天”、“总时长挑战”等活动,UP 主可以在自己的粉丝群内发起挑战,增强互动。
- 复购推荐:当粉丝完成某课程后,UP 主可以根据其数据表现(比如姿态达标率高、完成度好),推荐进阶课程。
3.4 从“一对多”到“能看见个体”
前面讲的群发、评语、调难度,其实都建立在同一个能力之上:UP 主能“看见”某个具体的粉丝。
传统视频跟练有一个结构性限制:UP 主只能“一对多”。发布一套课,能看到播放量、点赞数、评论,但看不到任何一个具体的人做操时发生了什么。如果粉丝在评论区说“这个动作我做不来”,UP 主最多只能回一句“可以试试退阶版”。但这个退阶版在另一个视频里,粉丝得自己去找、自己去对应节奏,体验是断裂的。
UP 主不是不想对个体负责,是没有工具去负责。
LeaScript 带来的变化,就在这里。因为每次做操的详细数据都会落盘(health2026xxxx.dat),UP 主可能“看见”某个具体的人:他在哪个动作上反复不达标,哪个动作他跳过了。
这种“看见”,是第三节所有服务能力的基础。没有它,群发只是群发,评语只是评语,调难度也只是空想。它把 UP 主从“只能看到一群人”,第一次带到了“能看到一个人”的位置。
这个能力,传统视频模式做不到。它也是 LeaScript 体系区别于传统架构的核心特色之一。
总结
在 LeaScript 体系下,脚本本身很难赚钱,但基于脚本产生的详细做操数据,可以让 UP 主提供精准的、有温度的、传统 App 无法提供的服务。从“卖脚本”转向“卖服务”,才是这个体系下真正可持续的商业路径。
四、健身 UP 主要做的事:从“创作者”到“服务者”
如果你是一位 UP 主,看到这里可能会问:这套架构把课程生产效率提高了,但对我个人来说,每天到底要做什么?和以前有什么不同?
这一节就来回答这个问题。
4.1 传统模式与 LeaScript 模式的分工差异
在传统模式下,一个健身 UP 主/团队要完成一条完整的生产链:
构思动作 → (真人)演示 → 录制 → 剪辑 → 配音 → 发布 → 回复评论。
在 LeaScript 体系下,这条链被拆开了:
- 动作标不标准:由原子层负责,算法工程师和高级教练定义好一次,全平台复用。
- 操编得好不好:由序列层负责,UP 主从动作库里挑动作、排顺序、设次数/时长。
- 课程怎么排:由课程层负责,UP 主给出待做清单(哪天做哪些操、几轮),流水线自动生成脚本。
- 数据怎么看:由报表系统负责,每次做操的数据自动落盘,自动生成图表。
UP 主需要亲自做的,主要是三件事:
- 给出课程的待做清单(图1)(决定“教什么”)。
- 查看粉丝的做操数据(了解“练得怎么样”)。
- 根据数据做出回应(决定“怎么服务”)。
其中,第 1 件事在传统模式下也是 UP 主要做的,但第 2、3 件事,是 LeaScript 体系带来的新变化。
4.2 日常可以做的事
这里说的“日常”,不是硬性要求,而是基于现有数据能力,UP 主可以做的事。做多做少,取决于 UP 主自己的节奏。
看数据
每天的做操数据会存放在 health2026xxxx.dat 文件中,并自动生成图表。UP 主可以:
- 看某位粉丝的单次做操图(图3),了解他在哪个动作上卡住了。
- 看某位粉丝的课程进度图(图6),了解他有没有按计划推进。
- 看“近 30 天含某 ID 的做操记录”(图7),了解某个动作在所有粉丝中的整体表现。
这些数据不需要 UP 主自己去算,系统已经整理好了。
给回应
看到数据之后,UP 主可以做出回应。回应的方式有两种:
- 针对单个粉丝:在粉丝发来的图表上写一条评语。这条评语会永久显示在该图表上。粉丝下次翻看时,还能看到 UP 主当时的反馈。
- 针对粉丝群:如果发现多位粉丝都卡在同一个动作上,可以发一条群消息,提醒大家注意。也可以隔一段时间做一次直播,集中答疑。
调课程
如果数据显示某个操对多数粉丝来说难度偏高(比如完成度普遍偏低),UP 主可以回 Launcher 里调整这个操的轮数,或者替换成退阶版本。调整之后,课程脚本会重新生成。
4.2.1 跟练初期的黄金期:用延伸课程给不同粉丝分层
用户刚开始跟练的那几天,是留存的关键期。如果头几天因为难度不合适而放弃,后面很难再拉回来。所以,UP 主在这个阶段主动盯紧数据、按段调整难度,是很有必要的。
具体可以这样做:
- 盯前 3 天的完成度:看某位粉丝在第 1 ~ 3 天的完成度。如果连续几天卡在同一个动作上,说明难度偏高。
- 建一个延伸课程:在 Launcher 里新建一份课程,把 prerequisite 设为前置课程的 ID,price 设为 0(因为前置课程已经收过费)。这份课程里的操,可以用更宽松的阈值版本,或者把轮数降下来。
- 让粉丝下载延伸课程:粉丝在前置课程界面里,能看到“延伸课程”入口。他点进去,选一个起始天数(通常是当前进度那天),就能开始跟练。
- 观察 3 天,再决定升级:如果粉丝在入门版上完成度稳定,再把他引导到主课程;如果还是跟不上,就继续用入门版。
prerequisite 在这里的作用,是让 UP 主可以在同一个时间点,为不同水平的粉丝提供不同难度的课,而互相不干扰。 这是传统视频模式做不到的——你不可能为一批新人单独剪一版视频,再为另一批人剪另一版。
如果延伸课程的定位是“覆盖不同难度”,建议里面每一个操的 ID 前两段,都在前置课程里找得到同类型的操。这样延伸课程的进度就能按“操类型”聚合到前置课程进度图里。如果延伸课程是专项修复或加餐挑战,不受这个约束。
4.3 核心能力的变化
传统模式下,UP 主的核心能力是:动作标准、讲解清晰、课程编排好看。
在 LeaScript 体系下,这些能力依然重要,但权重有所变化。因为:
- 动作标准,已经由原子层保证了(每个动作的阈值都是统一的)。
- 课程编排,已经由课程层的校验规则保证了(不会出现休息日缺失、轮数超限这类问题)。
UP 主的核心能力,更多转向了数据解读和粉丝服务:
- 能看懂数据,知道哪个动作卡住了,哪个粉丝掉队了。
- 能给出有温度的反馈,不是机械地回复“继续加油”,而是针对数据说具体的话。
- 能根据数据调整课程,让课程越用越适合这批粉丝。
4.3.1 不阻断沟通:私域服务的可能性
前面讨论的都是“UP 主能在 LeaScript 里做什么”。但有一件事,规范有意没有限制,反而留出了空间:UP 主和粉丝之间,可以直接沟通。
LeaScript 不限制双方交换联系方式。UP 主可以加粉丝微信,粉丝也可以主动找 UP 主。规范只负责定义课程结构和数据记录,不介入双方的关系。
这一点,在“服务者”的定位下,反而变得重要。因为很多深度服务,不是靠 App 内的一个按钮完成的,而是靠持续的沟通:
- 粉丝做完操,把 health2026xxxx.dat 发给 UP 主;
- UP 主看完数据,在微信里说一句“你这周腰部角度一直在 165° 左右,比上周好多了”;
- 粉丝如果有疑问,可以直接问 UP 主“我今天腰有点酸,这个操要不要停一天”;
- UP 主可以回复“停一天,做做拉伸,我把拉伸操的链接发你”。
这个过程,不需要平台介入。它靠的是两个人之间的直接沟通。
规范不做限制,是因为这件事本身不需要限制。UP 主想不想建微信群、想不想加粉丝好友、想不想做一对一沟通,是 UP 主自己的选择。
但这只是“不限沟通”,还不足以把私域做起来。
私域听起来很像“线上健身房”:粉丝信任你,进入你的场子,你给他们提供别处得不到的指导。但传统线上健身房有一个始终没解决的短板——教练看不到学员在家练得怎么样。
传统线上健身房里,教练能做的,是发课程计划、发动作讲解、发群消息。但学员在家练的时候,动作对不对、有没有卡住、有没有偷懒,教练一概看不到。所以所谓的“私教服务”,很多时候只能停留在“一对多”的层面——发一样的计划、发一样的提醒,最多在群里回一句“坚持就是胜利”。
LeaScript 的详细做操数据,恰好补上了这个短板。
因为每次做操的详细数据都会落盘,UP 主第一次能“看见”某个具体的人:他在哪个动作上反复不达标,哪个动作他跳过了,哪一天他根本没打开 App。这让“线上健身房”第一次有了“私教能看到学员动作”的能力——虽然不是在旁边实时看着,但通过数据,依然可以做到“我看见你了”。
传统私域,工具不配套,教练只能靠印象服务;LeaScript 的私域,有数据支撑,教练能靠数据服务。这就是它补上的短板。
这也是它和传统大平台的区别。 大平台倾向于把用户留在 App 内,不鼓励 UP 主和粉丝建立 App 外的联系。而 LeaScript 不设这个限制——因为它的定位不是“平台拥有用户”,而是“UP 主服务粉丝”。
4.4 小结
LeaScript 并不取代 UP 主。它做的事情,是把 UP 主从重复劳动里解放出来。
以前,UP 主要花大量时间在录制、剪辑、配音上;现在,这些工作由流水线完成。UP 主省下来的时间,可以用在只有人才能做的事上:理解粉丝、陪伴粉丝、服务粉丝。
这也是 LeaScript 体系对 UP 主这个角色的基本定位:从“内容创作者”,逐步转向“服务提供者”。 这个转变不是强制性的,但数据能力的出现,让这个转变有了落地的基础。
延伸阅读
课程层建立在操层之上。如果你还不了解操层的 <workout>、<state2>、<pose> 语法,建议先阅读:《LeaScript:面向端侧/视觉跟练的动作脚本规范》
联系我们
如果你对 LeaScript 感兴趣,想进一步了解如何快速上手、怎么摆放手机,或者探讨如何制作并发布自己的课程,欢迎添加我们的微信,随时交流。
(扫码添加,备注“LeaScript”)